Per 25 anni, i crittografi hanno sospettato che i misteriosi "seed" di crittografia della NSA potessero nascondere una backdoor. L'intelligenza artificiale (IA) Claude di Anthropic ha risolto l'enigma in meno di 30 minuti, scoprendo una spiegazione sorprendentemente banale.
Claude AI svela il seme crittografico NSA irrisolto da 25 anni
SCRITTO DA

CONDIVIDI
Punti chiave
- Anthropic afferma che Claude ha risolto un mistero di crittografia della NSA che durava da 25 anni in meno di 30 minuti.
- I cinque semi della curva a campo primo del NIST risalgono a un generatore dell’era Unix che utilizzava timestamp del 1997-98.
- La taglia di 36.864 dollari offerta da Anthropic è andata all’ISRG, mentre l’origine del seme B-163 rimane irrisolta.
Per decenni, alcuni dei crittografi più brillanti del mondo hanno inseguito un fantasma. Cinque curve matematiche utilizzate per proteggere le comunicazioni su Internet contenevano numeri misteriosi forniti dalla National Security Agency (NSA), e nessuno riusciva a spiegare in modo soddisfacente da dove provenissero quei numeri. Le teorie andavano da scherzi dimenticati a vulnerabilità inserite deliberatamente. Poi l’IA Claude di Anthropic ha tentato di risolvere l’enigma e ha ricondotto i numeri a un vecchio programma per computer e a timestamp risalenti a quasi tre decenni fa.
Un mistero lungo 25 anni con la NSA al centro
La storia ha inizio alla fine degli anni ’90, quando i matematici stavano sviluppando standard per la crittografia a curve ellittiche, un metodo per proteggere le informazioni digitali utilizzando la matematica avanzata. Cinque curve, note come P-192, P-224, P-256, P-384 e P-521, finirono per diventare parte degli standard pubblicati dal National Institute of Standards and Technology (NIST). La loro struttura matematica contribuì a proteggere siti web, transazioni finanziarie e comunicazioni governative.
 Ma ecco il colpo di scena. Ogni curva era stata costruita utilizzando un misterioso numero iniziale a 160 bit chiamato «seed» (seme). Chiunque poteva verificare la procedura matematica utilizzata per generare le curve, ma nessuno sapeva come la NSA avesse scelto quei numeri originali. Quella domanda senza risposta alimentò le speculazioni secondo cui l’agenzia avrebbe potuto selezionare deliberatamente i seed per nascondere una vulnerabilità che solo i propri specialisti potevano sfruttare.
I crittografi Neal Koblitz e Alfred Menezes hanno esaminato la controversia nel loro articolo del 2015, “A Riddle Wrapped in an Enigma”. Non è mai stata dimostrata l’esistenza di una backdoor effettiva, ma il mistero non ha voluto spegnersi.
La frase segreta che apparentemente non è mai esistita
Per anni, la spiegazione prevalente ha coinvolto il matematico della NSA Jerry Solinas, che secondo quanto riferito avrebbe fornito i semi originali. Solinas e altri ricordavano che i numeri erano stati generati tramite l’hashing di frasi umoristiche in inglese, forse qualcosa di simile a «Jerry deserves a raise» («Jerry merita un aumento»). L’hashing converte le informazioni in un’impronta matematica di lunghezza fissa. Purtroppo, nessuno ricordava le frasi esatte e, a quanto pare, il computer originale era stato sostituito.
Lo stesso Solinas tentò di ricostruire il processo senza successo. Il mistero alla fine acquisì un valore monetario. Nell’ottobre 2023, il crittografo Filippo Valsorda ha offerto una ricompensa di 12.288 dollari a chiunque fosse in grado di spiegare l’origine dei semi. Un accordo di abbinamento a scopo benefico ha portato il potenziale premio a 36.864 dollari. Per tre anni, la somma è rimasta non reclamata. Poi è entrato in scena Claude.
Claude trova la risposta nascosta in bella vista
Secondo la ricerca di Anthropic pubblicata il 16 ottobre, un dipendente ha chiesto a un modello di ricerca interno di Claude di indagare sui semi senza menzionare la teoria di lunga data della frase segreta. Il modello ha iniziato a esaminare gli schemi associati a programmi informatici più vecchi. Un indizio è saltato subito all’occhio. Diversi semi contenevano gruppi di numeri i cui bit più alti erano costantemente pari a zero, uno schema con una probabilità di circa 1 su 5.810 di apparire casualmente. Ciò indicava lrand48, un generatore di numeri pseudocasuali comunemente disponibile negli ambienti di programmazione dell’era Unix. A differenza dei processi veramente casuali, i generatori pseudocasuali producono sequenze prevedibili una volta noti i loro valori iniziali. Claude ha risalito a ritroso la sequenza matematica, ha ricostruito gli stati interni del generatore e ha riprodotto esattamente i semi pubblicati. Poi è arrivata la vera sorpresa.
I valori iniziali corrispondevano a timestamp Unix, normali rappresentazioni numeriche di date e orari, risalenti al 1997 e al 1998. Il ragionamento registrato dal modello rifletteva la sua stessa apparente incredulità. «È sbalorditivo: risolve un mistero che durava da 25 anni.» L’intera operazione ha richiesto meno di 30 minuti.
Cinque curve, cinque timestamp e una corrispondenza straordinaria
I valori iniziali recuperati hanno ricondotto le cinque curve del campo dei numeri primi del NIST a date specifiche comprese tra maggio 1997 e aprile 1998. La curva P-192 aveva origine da un timestamp corrispondente al 18 maggio 1997, mentre la P-521 risaliva all’8 agosto dello stesso anno. P-256 seguì il 16 agosto, P-384 il 30 agosto e P-224 il 3 aprile 1998. La procedura appariva quasi comicamente semplice. Inizializzare un normale generatore di numeri casuali con un timestamp, produrre semi candidati, verificarne la conformità ai requisiti matematici e continuare la ricerca fino a quando non emerge una curva accettabile.
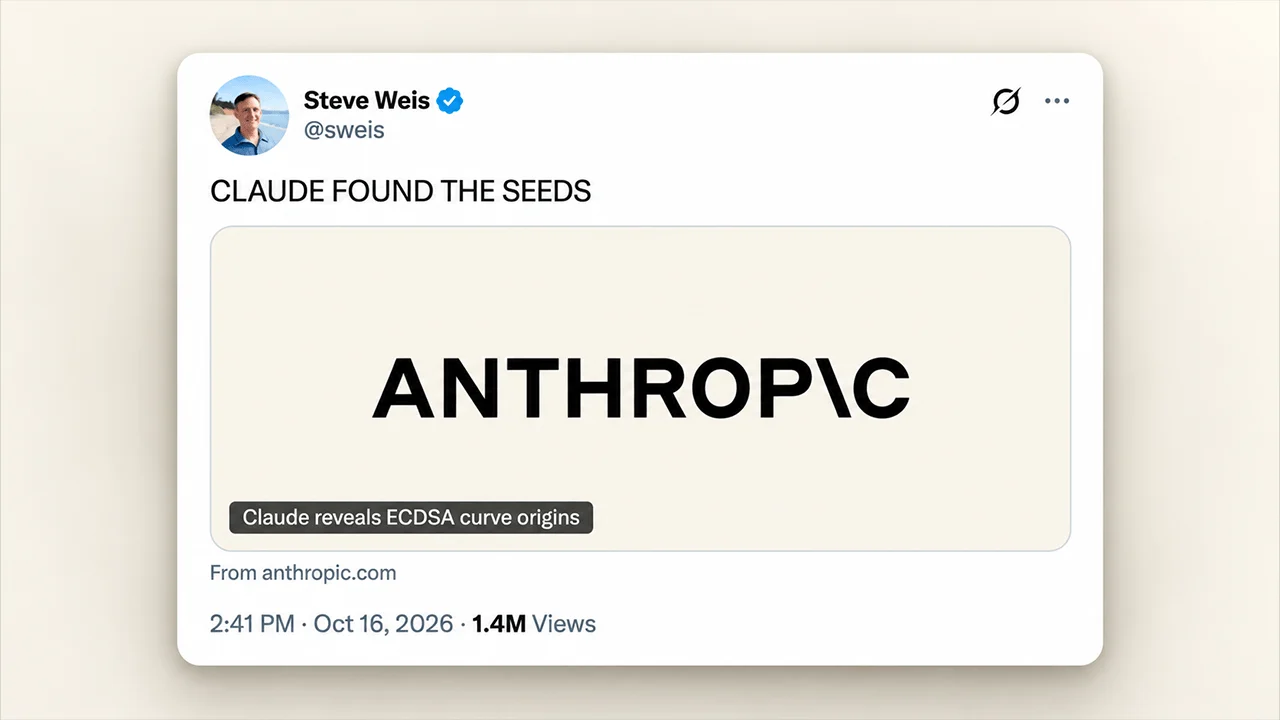
Ecco un video che lo spiega: https://t.co/BEC7wJ641p
— Steve Weis (@sweis) 16 ottobre 2026
Per P-256, il seme accettato è apparso al candidato numero 1.842. Per P-224, ci sono voluti 7.026 candidati. Le corrispondenze erano esatte, riproducendo tutti i 160 bit dei semi pubblicati anziché limitarsi a produrre numeri dall’aspetto simile. Valsorda ha riprodotto in modo indipendente i risultati utilizzando il linguaggio di programmazione Go, confermando i risultati. Anthropic ha inoltre rilasciato il codice per consentire ad altri di verificare il lavoro. I risultati forniscono una solida prova matematica a sostegno del metodo di generazione, sebbene non stabiliscano con precisione chi abbia gestito il software originale o perché determinati candidati siano stati scartati.
Cosa significa questa scoperta per la sicurezza di Internet
Le implicazioni sono rassicuranti, sebbene non costituiscano una garanzia universale di sicurezza. Una preoccupazione di lunga data riguardava la possibilità che la NSA disponesse di sufficiente libertà nella selezione dei semi per scegliere deliberatamente curve matematicamente vulnerabili. Il processo ricostruito sembra aver offerto molte meno opzioni di quante ne richiederebbero alcuni attacchi ipotetici. I ricercatori di Anthropic hanno stimato circa 30 bit di libertà di selezione in base a ipotesi generose, una cifra notevolmente inferiore ai circa 70 bit contemplati in uno scenario proposto di selezione delle vulnerabilità.
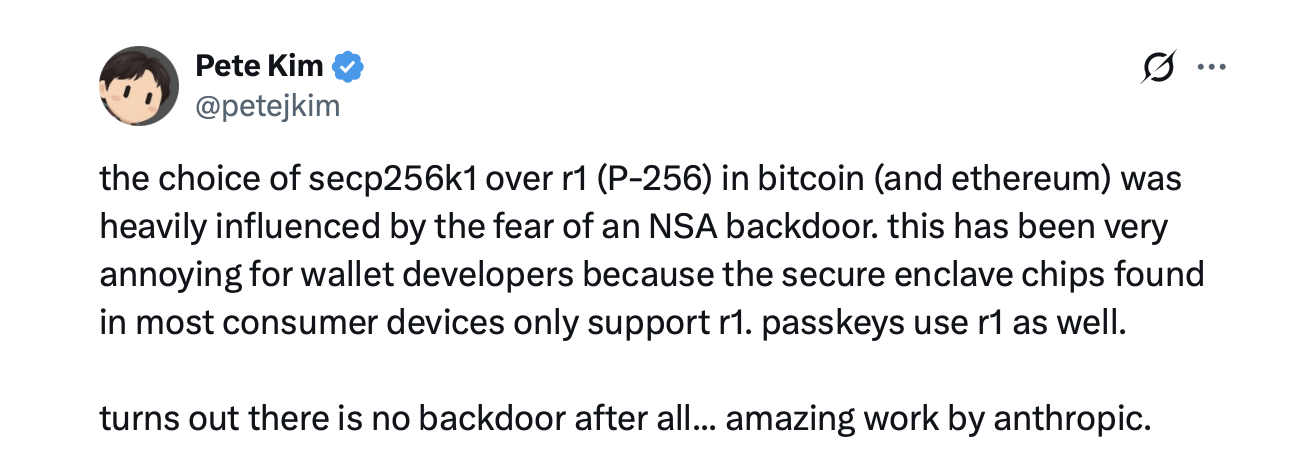
Ciò rende questa particolare teoria della backdoor sostanzialmente meno plausibile. È importante sottolineare che la scoperta non compromette la crittografia a curve ellittiche né stabilisce che ogni possibile punto debole sia stato escluso. Inoltre, non influisce direttamente su Bitcoin o Ethereum, che utilizzano una curva ellittica diversa chiamata secp256k1.
Gregory Maxwell smorza l’entusiasmo per il grande momento di Claude
È interessante notare che lo sviluppatore di Bitcoin Gregory Maxwell ha espresso un parere meno entusiasta, affermando su Hackernews di aver suggerito di indagare sullo stesso mistero crittografico il 20 settembre a un amico con crediti Anthropic AI in scadenza. L’agente di IA dell’amico ha dedicato ore al problema senza successo, lasciando Maxwell poco impressionato dalle sue capacità di ragionamento.
Maxwell, critico schietto dell’approccio di Anthropic all’IA, si è chiesto se l’azienda avesse limitato le capacità del modello del suo amico e ha ironizzato sulla pubblicità che circonda la scoperta di Claude. Si è fermato prima di rivendicarne il merito o contestarne i risultati, suggerendo che la differenza nei risultati potesse semplicemente riflettere il modo in cui l’IA era stata guidata.
«Non sto dicendo questo per suggerire che Misanthropic abbia di nuovo dirottato il lavoro di qualcun altro: si tratta di una domanda ovvia che sicuramente molte persone si sono poste e il successo dipendeva presumibilmente da un uso esperto (che non è stato assolutamente applicato nell’esempio del mio amico)», ha scritto Maxwell. «Ma mi viene da chiedermi se l’azienda abbia inavvertitamente compromesso le prestazioni del modello».
La taglia viene pagata, ma rimangono dei dubbi
La scoperta ha finalmente risolto la sfida lanciata da Valsorda tre anni fa. Il team di Anthropic ha destinato la ricompensa di 36.864 dollari all’Internet Security Research Group, che gestisce Let’s Encrypt. Valsorda ha descritto la scoperta come qualcosa che «contribuisce a scrivere una pagina di storia della crittografia e rafforza la nostra fiducia in queste primitive crittografiche fondamentali». Rimangono tuttavia alcuni punti in sospeso. I ricercatori non hanno spiegato appieno perché alcuni candidati matematicamente accettabili siano stati scartati, e l’origine del seme di un’altra curva, la B-163, rimane irrisolta.
Tuttavia, il mistero principale sembra risolto. Dopo decenni di sospetti, speculazioni e tentativi falliti di ricostruire una frase segreta che si supponeva dimenticata, la risposta si trovava all’interno di una normale routine informatica degli anni ’90. I misteriosi numeri della NSA non nascondevano necessariamente un segreto elaborato. Potrebbero semplicemente aver tenuto il conto del tempo.
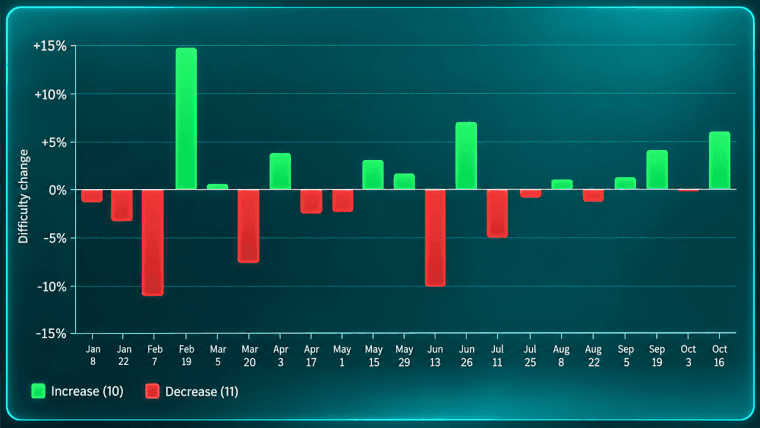
La difficoltà di mining di Bitcoin è aumentata del 5,92% raggiungendo i 140,58 trilioni, segnando il terzo aumento più consistente del 2026, mentre l’hashrate ha superato 1 ZH/s.
Leggi ora: Difficoltà mining Bitcoin +5,92%, terzo aumento del 2026

Questo articolo è stato tradotto dall'inglese tramite IA. La versione originale in inglese è la fonte autorevole; le traduzioni automatiche possono contenere imprecisioni, in particolare nella terminologia legale e normativa.